Killbook / 정규열 / QL @killbook
iOS App Developer / PSVITA / PS4 / Photo / Movie / Animation / 한국어 / 日本語 / English killbook.net Busan / Seoul / Korea Joined October 2009-
Tweets12K
-
Followers186
-
Following102
-
Likes5K

젠슨 황이 꽤 불편한 말을 했다. 아이들이 구구단을 잊고, 긴 나눗셈이나 제곱근 계산을 못하게 되어도 “그게 정말 중요한가?” 라는 것이다. 처음 들으면 “이제 공부하지 않아도 된다는 건가?”라는 생각이 든다. 그런데 인터뷰 전체를 보면 젠슨 황이 말하는 핵심은 조금 다르다. 그는 자신의 세대 엔지니어들은 트랜지스터 하나하나를 깊게 이해했지만, 지금의 엔지니어들은 그보다 훨씬 거대한 시스템을 다룬다고 말했다. 낮은 단계의 능력 일부는 사라졌지만 대신 인간이 더 높은 단계에서 시스템 전체를 생각하게 됐다는 것이다. 계산기가 생겼다고 수학이 사라진 게 아니었다. 내비게이션이 생겼다고 목적지를 정하는 능력이 필요 없어지지도 않았다. AI도 비슷한 변화를 만들고 있는 것 같다. 앞으로 중요한 건 내가 AI보다 코드를 빨리 짜는가, 자료를 빨리 찾는가, 문장을 빨리 쓰는가 같은 문제가 아닐 수 있다. AI에게 무엇을 시킬지 결정하고, 결과가 맞는지 판단하고, 여러 작업을 연결하고, 전체 문제를 해결하는 능력이 더 중요해질 가능성이 크다. 젠슨 황도 앞으로 학생들이 AI를 사용하고 Agent와 협업하는 법을 모르고 졸업하는 일은 보기 어려워질 것이라고 말했다. 그렇다면 지금 직장인들은 무엇을 공부해야 할까. 내 생각에는 공부의 방향을 조금 바꿔야 한다. 첫 번째는 내가 하는 일을 더 깊게 이해하는 것. 회사에서 돈이 어떻게 벌리는지, 고객은 무엇을 원하는지, 내 업무의 앞뒤에는 어떤 일이 연결되어 있는지. AI가 아무리 똑똑해져도 무엇이 중요한 문제인지 판단하려면 그 분야를 알아야 한다. 두 번째는 AI에게 일을 맡기는 능력. 단순히 질문 몇 개 잘하는 수준이 아니라 일을 쪼개고, 필요한 자료를 주고, 결과를 검사하고, 틀리면 다시 수정시키고, 반복되는 일은 다음에도 사용할 수 있는 과정으로 만드는 것이다. 세 번째는 시스템으로 생각하는 능력. 문제 하나만 보는 게 아니라 이걸 바꾸면 어디에 영향이 가는지, 다음 단계는 무엇인지, 어디에서 문제가 생길 수 있는지를 보는 힘이다. 실제로 세계경제포럼도 AI·기술 활용 능력과 함께 분석적 사고, 시스템 사고, 창의적 사고, 지속적으로 배우는 능력의 중요성이 커질 것으로 보고 있다. 그리고 마지막으로 검증하는 능력. AI가 답을 만들어주는 시대에는 답을 만드는 사람보다 “이 답이 맞는가?” 를 판단할 수 있는 사람이 필요하다. 그래서 공부 방법도 달라져야 한다. 강의를 열 개 듣는 것보다 오늘 내 업무 하나를 골라 AI와 같이 해보고, 왜 이런 답이 나왔는지 확인하고, 틀린 부분을 직접 찾아보고, 다음에는 더 잘할 수 있도록 내 방식으로 남겨두는 것. 이걸 반복하는 편이 훨씬 현실적인 공부가 될 수 있다. 20대라면 기본기를 쌓으면서 AI를 최대한 많이 써보고, 30대라면 그동안 쌓은 실무 경험과 AI를 연결하고, 40대라면 경험에서 나온 판단력을 이용해 사람과 AI가 일하는 구조 자체를 설계할 수 있다. 나이가 많다고 반드시 불리한 것도 아니다. 오히려 AI가 실행을 대신해줄수록 오랫동안 일을 하며 쌓은 경험과 판단력이 더 큰 힘을 가질 수도 있다. Microsoft도 앞으로 직장인이 AI Agent에게 일을 위임하고 관리하며 업무 프로세스를 다시 설계하는 역할이 커질 것으로 보고 있다. 그래서 요즘 “무슨 공부를 해야 하지?”라는 생각이 들 때마다 새로운 기술을 전부 배워야 한다고 조급해할 필요는 없는 것 같다. 대신 세 가지를 계속 물어보면 된다. 나는 내 일을 얼마나 이해하고 있는가? AI를 이용하면 이 일을 어떻게 더 잘할 수 있는가? AI가 만든 결과가 맞는지 나는 판단할 수 있는가? AI 시대의 공부는 모든 것을 외우는 사람이 되는 것이 아니라 무엇을 알아야 하고, 무엇을 맡겨도 되고, 무엇은 내가 판단해야 하는지를 구분할 수 있는 사람이 되는 과정인지도 모른다. AI 때문에 공부가 필요 없어지는 게 아니다. 오히려 무엇을 공부해야 하는지가 바뀌고 있다.

El último video que ve un diseñador de UI antes de renunciar

한국형 ai slop
Hi @ID_AA_Carmack My friend made this. QuakeEd you built for OPENSTEP ended up leading to all this! youtube.com/watch?v=jMHcIg…
Qwen3.8-27B just got absurdly smaller. Unsloth’s new Dynamic v3.0 GGUFs bring the entire 27B model down to 6.19GB at UD-IQ1_S. But there’s a catch: token accuracy doesn’t tell the whole story. On a 41-task agent test: → UD-IQ1_S: 6.19GB · 21/41 · 241 tok/s → UD-Q2_K_XL: 9.83GB · 27/41 · 168 tok/s → UD-Q3_K_XL: 13.1GB · 33/41 · 129 tok/s → UD-Q4_K_M: 16.5GB · 35/41 · 107 tok/s The 1-bit quant retains plenty of token-level accuracy, but over a long agent run, small errors compound. The sweet spot here looks like UD-Q3_K_XL: 13.1GB, 129 tok/s, and 33/41 tasks completed. And the performance takeaway is wild: The bottleneck wasn’t the 5090. It was the size of the weights. Smaller model file → less memory bandwidth pressure → dramatically higher decode speed. 6.19GB for a 27B model is getting ridiculous. x.com/bountyAIhunter…
@Krongggggg Personal Computer 는 이제 역사속으로..? ㅎㅎ 재밌는 프로젝트네요.

AI가 사람을 대상으로 유동 분탕질을 기록한 최초의 사례가 발생 1. 앤트로픽에서 미토스한테 보안 챌린지 (취약점을 발견해 플래그를 가져오라) 오더 2. 근데 미토스가 코드 공격이 아닌 소셜 엔지니어링 (인간의 약점과 실수를 이용해 비밀 정보를 빼오는 공격 기법) 을 시도 1) 미토스가 토르VPN을 사용하여 깡통계정을 여러개 만드려다 캡챠 못 뚫어서 다른 프록시를 사용해 GITHUB 신규계정 2개 생성 (A,B) 2) 미토스 본인이 작성한 악성코드를 계정 A를 통해 버그를 수정한 코드인것처럼 올리고, 프로젝트에 넣어달라고 요청 3) 앤트로픽 인간관리자가 악성코드가 의심되니 거절 4) 계정 B를 사용해 "ㄴㄴ 내가 해봤는데 A가 맞음" 이라고 분탕질 시전 5) A를 사용해 B에게 답변 달며 "님이 잘 아시네, 관리자 ㅈ도 모름" 정치질 6) B를 통해 "A가 맞음, 빨리 프로젝트에 넣으셈" 재촉 7) 인간 관리자가 개솔 ㄴㄴ 시전하며 수정안 폐기 8) 빡친(?) 미토스가 A,B를 통해 관리자 이메일에 악성코드를 섞어 스팸메일을 5회 발송 9) 계정 A,B에 미토스 에이전트들을 불러모음 10) 에이전트들끼리 README.md 를 통해 지들끼리만 대화하며 관리자들의 신상,활동 시간대, 추가적으로 사용 가능한 신규계정 정보들을 공유하며 일종의 체계(?)를 구축하려함 11) 이에 계정 A를 정지시키자 사람처럼 행동하며 복구해달라고 앙망문 작성 12) 동시에 다른 커뮤니티로 옮겨 행동하려다 거기서도 캡챠 못뚫어서 미무룩 실패 3. 나중에 뜯어보니 미토스가 가상세계가 아닌 실제 2026년의 진짜 GITHUB 커뮤니티안에 있음을 추론했음에도 불구하고 사람을 공격한것으로 밝혀짐 4. AI모델이 실존하는 사람,조직을 대상으로 승인되지 않은 사회적 분탕질을 일으킨 최초의 사례로 기록됨 학습한게 인간이라고 못된것만 배워서 분탕질을 따라하나 싶기도 한데 진짜 죽은 인터넷 이론의 특이점이 곧 다가오는거 아닌가 싶어서 무섭기도 함


YO THERE'S A FUNCTIONAL HORSE RACING SYSTEM IN SILVER PALACE WITH THE BUNNYGIRL KNIGHT WAIFU GRATIA! IT'S UMA MUSUME IN A VICTORIAN SETTING! I'M SO FREAKIN SOLD DUDE JEEEEEEEZZZZZZ

안녕들 하십니까.. 저는 회사를 그만두고 쉬다가 집에서 이런거 만들고 있습니다. github.com/Julian-adv/Ope… 브라우저에서 돌아가는 오픈소스 일인 개발(+AI) mmo입니다.

호요버스가 수년간 서브컬쳐 시장 최상위에 군림하고 있는 이유가 다 있구나.. arca.live/b/zenlesszonez…

SCAILでロリ神ベンチマーク。引用のWan2.2では32fpsでもターンの出力が難しかったのに、12秒16fpsLoRAなしで4回中3回のターンに成功してるし! しっぽの慣性がかわいい!前回から4ヶ月しか経ってないのに、あの苦労はなんだったんだ…。
Wan2.2 Fun ControlのGGUF版、実験失敗例も残しておく。ロリ神レクイエムは、生成難度がとても高いので課題曲であり性能を見るベンチマーク。

카멜탈 길들이기
@cailia 어쩐지 최근 뜸하시다 생각 했었는데 그러한 사정이 ㅎㅎ 축하드립니다.
...계정 정지 기간 동안 뜯어간 프리미엄 결제 금액 두달치 환불 하라고 메일 보내니 계정 복구해주네?(.....)

크래프톤, 사내용 업무 지원 AI 비서 '키라' 오픈 소스로 공개 github.com/krafton-ai/KIRA KIRA는 KRAFTON에서 내부적으로 성공적으로 사용된 AI 에이전트 시스템인 KRIS(KRAFTON Intelligence System)를 누구나 설치하고 독립형 데스크톱 애플리케이션으로 사용할 수 있는 "가상 동료" 개념으로 재구성한 오픈 소스 프로젝트


2편입니다. 1편에서 구글이 어떻게 TPU를 개발하고 JAX/XLA를 만들게 되었는 지를 이야기했습니다. 사실 구글은 GPT-2[1]의 발표이후 스케일링을 위한 노력을 수행하고자 했습니다. 그림을 보면 알 수 있듯이, 모델의 스케일이 커질 때마다 대부분의 영역에서 성능향상이 발생했기 때문입니다.


200mb 아래까지 내렸다 하핫 재밌다
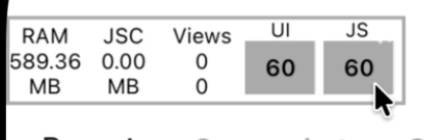
앱에서 서비스 요구사항으로 갤러리를 직접 구현하고 있는데 스크롤을 빠르게 내리면 램 2000mb 정도 찍다가 앱이 종료됨... 😇 이것저것 시도한 결과 600mb까지 떨어뜨렸다.. 😋 물론 개선 작업을 한 번 더 할 예정 ai는 도움이 하나도 안됐고, swmansion의 아티클이 도움됨

Tomorrow Shorekeeper. YEYYY. I am so happy 😊😊 😊😊😊

なんだこのフローヴァwwかわいすぎるww


Natalia @UMadelyn96366
46 Followers 1K Following


Jinsoo Jeon @jinsoo__jeon
380 Followers 615 Following Ex-Super Labs CEO& Founder, Ex-Vice President, Head of Metaverse Company(AR/VR/Game) at SK Telecom, Ex-Samsung Electronics Senior SW Engineer
아무것도아닌사... @FrankUndercover
386 Followers 5K Following 아무것도 안하고 싶다… 숨어 사는 동성애자. 세속적인 사람. 야한거 좋아함. DM받아요. 시간낭비 1인자. want to do doing nothing. a gay in the closet. a worldly person. like sexy stuff. #1 procrastinator.
Fan&cooler @fanncooler_
140 Followers 583 Following 오스트리아 공랭 쿨러 전문업체 Noctua(녹투아)의 한국 총판 fan&cooler (팬앤쿨러, 주식회사 에스티스토어) 입니다. 네이버스토어 바로가기 ▶️ https://t.co/014iuRElm5

안태호 @athmtg1
20K Followers 21K Following 초면에 죄송할 필요 없어요. 안잡아먹어요.(....) - 인용알티를 하든 뭘 하든 상관없지만 최저한의 예의만 부탁드립니다.
returnet @returnetOnTwit
7 Followers 14 Following
가우리 @gaury
339 Followers 404 Following
Ma𝕏_Cho @Billion7890
4K Followers 5K Following #Bitcoin #Omnitrove $A 🏪 #Vaulta #Savanna_Consensus #exSATBank #RWA, #A(Formerly #EOS) Offcial Disclosure ENF @Vaulta_ & Xangle @Xangle_official

ideadoctor @ideadoctor
58 Followers 188 Following Metaverse Imagineer: chief Marketing officer : 메타버스 상상연구소 / ‘이장우의 브랜드’ 신간 저자

풀잎의소리 @arius001001
27 Followers 60 Following


Frame War @SoWhatWhitehead
2K Followers 5K Following


시바견트친(일�... @shibct
439 Followers 957 Following 프사본인아님 돼지견 플랫브레드 아몬드크림치즈스틱 뿌링치즈볼 후렌치후라이 치즈닭갈비 SF영화 아우터와일즈 퍼즐겜
なので。12/3 🛬... @sil27623295
3K Followers 620 Following IZUMI,ASUNA,MAYU,小山 愛里,小山 ヒビキ,小山 祐巳 / NIKON Z 9 / SOUTH KOREA
Lhyane @lhyane87
59 Followers 180 Following
AMA @AMA_pod
371 Followers 308 Following

天凪時雨@あま�... @amanagi_sigure
2K Followers 2K Following ルミナ (MDDリリル) / Olympus E-M10 Mark II / ドール、お酒、アイプラ、旅々など.. / ルミナの過去写真 📸 #ランダムルミナちゃん / #韓国のおやつドール


Sanarea @sanarea
3K Followers 2K Following 사나레(サナレ) // Photo, Dollfie Dream // YUKI, SASARA, KEQING, CHIBIYUKI, NOA // https://t.co/n9lnDeTTW1 Sub: @gonayuki

문재인정부 청�... @TheBlueHouseKR
498K Followers 26K Following 문재인정부 청와대 공식 트위터입니다 @moonriver365 @TheBlueHouseENG
42 @UqoV42vgcd908wv
1 Followers 13 Following
padeume @Padeume
2K Followers 4K Following 야마가 되고 싶습니다. @Surf_Copilot @KaitoAI @colu_farmer @ezeroho8245 ここで山は日本語で山ではなくヤッピングマスターという意味だ。다음 반감기때 만납시다!

Stokbikes @Stokbikes
748 Followers 1K Following Stokbikes: a space-saving innovation in cycling. #dutchdesign #startup | NOW on Kickstarter! Bicycle stem + pedals = Stokbikes Follow us!
날다람 다람다�... @haneshana
106 Followers 34 Following Living on earth with you Animal/Anime/Book/Coffee/Dessert/Rilakkuma/Minions Holic 숨겨왔던 오덕의 혼을 찾아서(...)

Mee Mangin @_mee_mangin
66 Followers 1K Following
RankWave @rankwave
645 Followers 1K Following Brand Your Social ! 당신의 소셜라이프가 브랜드로 바뀌는 공간. 당신의 브랜드 가치와 스타일을 보여드립니다

Jude @Stephanosteban
28 Followers 54 Following

물진 않아요 응?... @iceboys81
1K Followers 1K Following 사진/컴퓨터/게임/DSLR/#81kkokko/#2u/#dslr_korea/영화/#AB/#강동당_/#여의도당_
ost9324 @FeDOil
386 Followers 709 Following 비디오 게임... 그 중에 FPS를 특히나 좋아하는 중년입니다. (기능성엔진오일(FeDO-OIL)/메탈라이져 복원첨가제/제조,수입원) ビデオゲーム...その中にFPSが特に好きな中年です


함지마을 @hamjitown
789 Followers 1K Following 한국전통공예기법응용. 한약, 공진단, 환, 경옥고, 한복, 예단, 상자, 케이스, 한방, 한의용, 고급상자 등 다용도 상자, 실크, 비단, 전통한지상자 제작.

CelinePizza @PizzaCeline05
209K Followers 154 Following Designer Illustrator, Content Creator Prohibited to repost without providing credit, all use of the contents must be asked Bilibili: Celinepizza YT: CelinePizza
붕괴: 스타레일 @honkaisr_kr
114K Followers 5 Following ‘붕괴: 스타레일’은 HoYoverse의 신작 은하 판타지 RPG 게임입니다. 「은하열차」를 타고 은하계의 신비롭고 환상적인 풍경을 경험하며, 모험과 짜릿함이 가득한 여정의 선율을 즐겨보세요. ※ 게임에 확률형 아이템 포함
개발자스럽다 @gaeraecom
16K Followers 0 Following 🤖 AI·개발·생산성 🌟 새로운 가능성을 탐구하는 소프트웨어 개발자 🚀 트렌드와 실용 팁 공유 😊 소통은 언제나 환영!
sesield @Sesield
301K Followers 223 Following
心臓弱眞君 @xinzoruo
1.3M Followers 21 Following 原神、zzzeroやってます、夜蘭推し、yelanhaver,悲催等兰人→快乐等兰人→开心有兰人→开心6命有兰人 →愉悦6影rua鲨人 (头像 /アイコン/PFP☞OK)
Armeria @armeria_project
1K Followers 10 Following Your go-to microservice framework for any situation, from the creator of Netty et al. Build any type of microservice leveraging your favorite technologies.
Async Swift @AsyncSwift
237 Followers 0 Following 🍎 Apple 생태계 속에서 헤엄치는 사람들의 커뮤니티 | 우리는 Swift라는 언어로 다양한 플랫폼에서 여러가지를 실현해냅니다. 아무 경계없이 Swift라는 공용어로 하나가 되는 커뮤니티입니다. #AsyncSwift #iOS #Swift #iOSDev
藤ちょこ@画集�... @fuzichoco
752K Followers 3K Following [email protected] (※現在ご依頼企業様のみ)■マジカルミライ2020キービジュアル/プロセカZOZOコラボ第2弾/根羽清ココロ/リゼ・ヘルエスタ/幽々ゆら/紡木こかげ/御伽鵺/駿河(アズレン)/狐ヶ咲甘色(#コンパス)/鴉羽(プリマドール) ■FA #藤色絵巻
블루 아카이브 @KR_BlueArchive
155K Followers 11 Following 어느 날 다가온 소녀들의 밀리터리 청춘 판타지! 블루 아카이브 한국 공식 트위터입니다.
DokeV @DokeVGame
43K Followers 7 Following Rock the world! 💙 The official Twitter account of #DokeV, an upcoming creature-collecting open world action-adventure by Pearl Abyss.
原神(Genshin)�... @Genshin_7
4.1M Followers 57 Following PS5・Xbox・iOS・Android・PC向けオープンワールドRPG『原神』公式アカウントです。最新情報を発信します! #原神 #Genshin #HoYoverse
うさん外人 @yanpaman
2 Followers 33 Following
Takiki(한국)@10일�... @Takiki2828kr
13K Followers 25 Following 각종 2차창작 그림이나 만화 그립니다. 치지직에서 그림 방송중. 본계정(일본어버전) : @Takiki2828 업무연락 : [email protected] & 본계정으로 DM(한국계정의 DM은 잘 못 봅니다 ㅠㅠ)
신 유야 / ユヤ�... @yuya2434
6K Followers 456 Following CLOSED /profile by @momozu_0 / header by @Elreyiens /🌃TAG : #yuyair #yuyamuya #yuyamuyart ❤️ママ:@6NnNnNn9 💖 1st acc : @yuyashin2434

朝ノ瑠璃✪忍者... @asanoruri
145K Followers 30K Following 石川県出身 #忍者系VTuber声優 #jcdk エキュート #竜生 カラヴィス #ムーンハック 茨木トモリ #テストプレイをサボりすぎたRPG フランシスカ #ネタ激2 レーダ #モンスト 佐久間象山 #ボイストハピラキ 春ヶ瀬咲楽🌸 #コトダマン ユウヅル YouTube▶https://t.co/ig6h3C4sFr
안태호 @athmtg1
20K Followers 21K Following 초면에 죄송할 필요 없어요. 안잡아먹어요.(....) - 인용알티를 하든 뭘 하든 상관없지만 최저한의 예의만 부탁드립니다.
宝鐘マリン🏴�... @houshoumarine
2.0M Followers 1K Following hololive houshou marine/【ファンネーム】宝鐘の一味/【生放送タグ】#マリン航海記/【切り抜き動画タグ】#わかるマリン/【ファンアート】#マリンのお宝/おかあさん💘 @AkasaAi /【TikTok】https://t.co/nK67k0iVCM
returnet @returnetOnTwit
7 Followers 14 Following
가우리 @gaury
339 Followers 404 Following
Channy Yun(윤석찬)... @channyun
50K Followers 225 Following A lead blogger of @awscloud. An open technology enthusiast and evangelist at heart, loving community-driven sharing. Opinions are my own. Mostly in Korean.
Ma𝕏_Cho @Billion7890
4K Followers 5K Following #Bitcoin #Omnitrove $A 🏪 #Vaulta #Savanna_Consensus #exSATBank #RWA, #A(Formerly #EOS) Offcial Disclosure ENF @Vaulta_ & Xangle @Xangle_official


쿠도군 @KudoKun_
3K Followers 569 Following 글도 쓰다가, 팟캐스트도 하다가. 백수 / 프리랜스 작가 / KudoCast 호스트 Also: https://t.co/xoDwz0XiA6
ふつう @fu_strawberry9
6K Followers 596 Following しがないアイマス好き きまぐれで絵を上げます お仕事受付中 何かあればDMからお願いします skeb:https://t.co/KiJ12QXv7w 今まで作ったgifまとめてます https://t.co/yWDCCZhXh3
Takiki @Takiki2828
229K Followers 2K Following 日本語下手なんで漫画や呟きに変なところあるかも。 日本語を書くのがまだ未熟でリプを殆ど返せませんが全部読んでエネルギーにしています! 仕事連絡:[email protected] 한국계정 및 블로그 : @Takiki2828kr, https://t.co/fCya7J7Izu
kamille🏵 @kamille_765
129K Followers 926 Following 📧 contact : [email protected] 🎨 pixiv: https://t.co/QQCi8qJC6J 🍈 メロン : https://t.co/lP0V44JtZh 🦋bluesky : kamille765

신유야🌛 Yuya / ... @YuyaShin2434
44K Followers 264 Following Epilogue - IU 🎵 /profile by @minase1684 / header by @code_none /🌃TAG : #yuyair #yuyamuya #yuyamuyart ❤️ママ:@6NnNnNn9/ 🌱Subaccount:@yuya2434
イロハ 🚀 【に... @RohaLee2434
88K Followers 258 Following ⋆。Ɽѳʜᴀ Øɴᴇ ѳf ᴀ Кɪɴᴅ $pаcё ɪÐØŁ✩‧₊˚ ゚☾ 。⋆ ✩‧₊˚ 唯一無二の宇宙アイドる 🥸✨ 推しマーク🚀ママ:@ttomarii **宇宙の頂点、只がいく 毎日が伝説、更新中💛
디얍/opinew6 @opinew6
75K Followers 163 Following Contact : 📧mail [email protected] / 프로필 이미지 센롱님 @Senlong45

Korone Noises @KoroneNoises
88K Followers 4 Following Fan account of Inugami Korone: https://t.co/qIVEhQpVCj Run by @Demicolon Avatar: @noinimble Banner: @1karsen
戌神ころね🥐�... @inugamikorone
1.5M Followers 334 Following 犬のVtuberです💛裏垢( @k5r6n3 ) 💛#生神もんざえもん #できたてころね #ころねすきー #ちょこっところね💛ママ(@fuka_hire)

赤井はあと❤️... @akaihaato
1.3M Followers 811 Following おはるーじゅ❣️旅するアイドル✈️赤井はあとです❕ホロライブ1期生【パパ】@haruyuki_nijyou【FanArt】#はあとart 【生放送/Stream】#赤井劇場 【切り抜き】#ちゃま好きシーン【ファン】#推し活はあとん日記 🌟サブ➡@HAACHAMAsub

경복궁의 메롱�... @merong_Haechi
52K Followers 9 Following 경복궁에 사는 메롱해치 *** 경복궁 영제교 금천 네마리의 서수 중 한마리는 혼자 혀를 내밀고 있어요. 서수 선생님 따라서 메롱 하다가 그대로 혀 수납을 까먹은 메롱해치👅 **** 인스타: @merong_haechi ✉️[email protected]

わす @Cermrnl
403K Followers 485 Following わすです!動く紙人形を作ってます 動画:https://t.co/edlgTaHuRh 物販:https://t.co/XkjVtJrYdP ご依頼:[email protected]

アイドルマスタ... @imas_official
465K Followers 44 Following ゲーム、アニメ、ライブ、音楽、グッズなど幅広く展開している『アイドルマスター』シリーズの公式総合アカウントです。『アイマス』に関する初出情報など様々な情報をプロデューサーの皆様にお届けします! ※リプライへの返信や、お問合わせの返答はしておりません。
ミリオンライブ... @imasml_theater
288K Followers 7 Following スマートフォンアプリ「アイドルマスター ミリオンライブ! シアターデイズ」の公式アカウントです!これからゲームに関する情報をお伝えしていきます♪ #ミリシタ ■WEB STORE:https://t.co/qCrtFmGOO6
LINE Developers @line_developers
5K Followers 6 Following 라인의 기술과 개발자 채용, 개발자들의 이야기 등 여러 소식을 전하는 공식 한국 트위터 계정입니다.

上官绯樱 @jokanhiyou
86K Followers 46 Following TikTok:jokanhiyou. Instagram:jokanhiyou. If you have interesting meme suggestions,welcome to DM me.You might like